一、引言
随着移动互联网和物联网的迅猛发展,数据规模呈现爆炸式增长,用户对个性化内容的需求日益强烈。个性化推荐系统已成为电商、资讯、视频等领域的核心引擎。百分点作为国内领先的数据智能企业,自2010年起持续深耕推荐系统,支撑了亿级用户和物品的实时推荐。本文将系统梳理百分点亿级个性化推荐系统的发展历程,剖析其典型实践架构,并重点探讨支撑推荐系统的数据处理与存储服务。
二、发展历程:从单机到亿级实时推荐
百分点的推荐系统演进大致经历了四个阶段:
- 离线推荐阶段(2010-2012):基于Hadoop MapReduce进行离线批处理,每天更新一次推荐结果,采用简单的协同过滤算法。受限于计算能力,仅能处理百万级数据。
- 近线/在线混合阶段(2013-2015):引入Spark和Storm,实现小时级模型更新和准实时推荐。存储层从MySQL转向HBase,支持千万级用户和物品。
- 实时化与亿级规模阶段(2016-2018):采用Flink作为实时计算引擎,结合Lambda架构,实现秒级特征更新和在线学习。存储引入Redis、Kafka、Elasticsearch,支持亿级用户和物品的实时召回与排序。
- 云原生与智能化阶段(2019至今):基于Kubernetes和微服务架构,实现弹性伸缩和混合云部署。引入深度学习模型(如Wide & Deep、DIN),推荐效果显著提升。存储层采用分布式数据库TiDB、对象存储和特征存储(Feature Store),支撑千亿级特征和样本。
三、实践架构:分层设计与核心模块
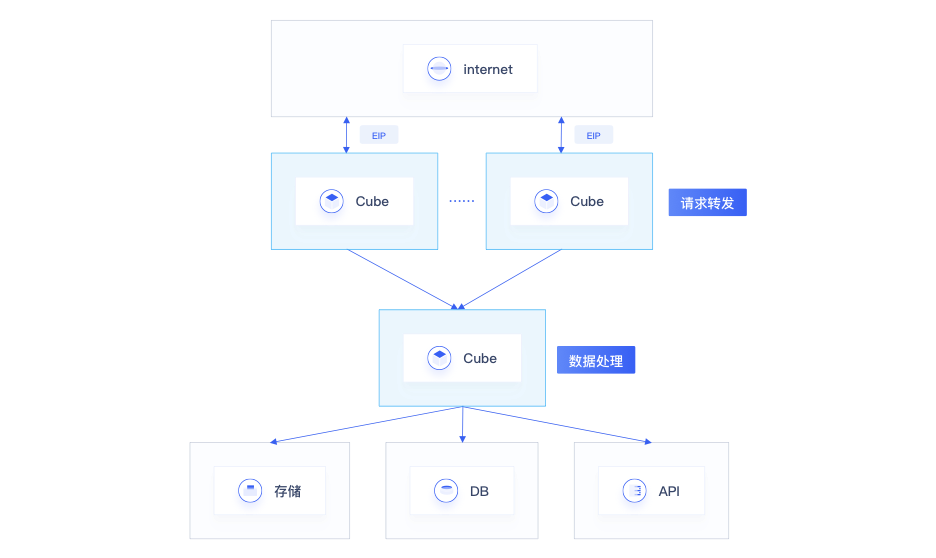
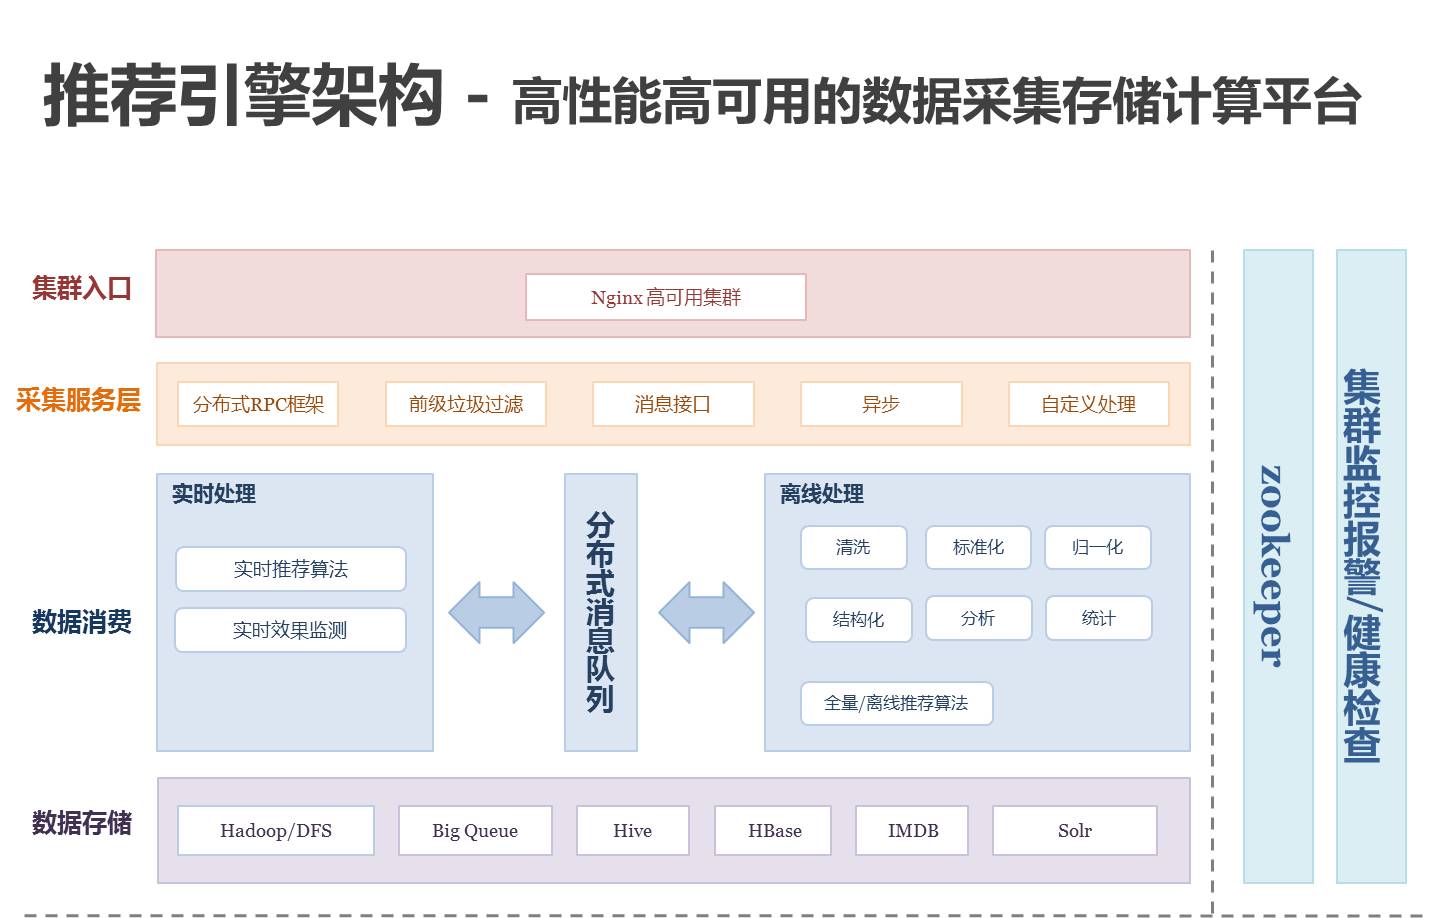
百分点亿级推荐系统的整体架构遵循分层设计原则,从上到下分为接入层、应用层、计算层、存储层和数据层。
- 接入层:负责请求路由、负载均衡和API网关,采用Nginx和Spring Cloud Gateway,支持高并发低延迟。
- 应用层:包含推荐服务、用户画像服务、物品画像服务等,通过微服务化部署,每个服务独立伸缩。
- 计算层:分为离线计算(Spark、Hive)、近线计算(Spark Streaming)和实时计算(Flink)。离线计算负责模型训练和全量特征生成;实时计算负责实时特征、在线学习和实时推荐。
- 存储层:为不同场景提供多种存储服务,包括:
- 实时特征:Redis、Aerospike
- 离线特征/样本:HDFS、HBase、Parquet
- 消息队列:Kafka、Pulsar
- 向量检索:Milvus、Faiss(用于嵌入召回)
- 元数据:MySQL、TiDB
- 数据层:包括数据采集(埋点、日志)、数据清洗、数据整合,形成统一的数据湖。
核心推荐流程分为召回、排序、重排三阶段:
- 召回:从亿级物品中快速筛选出数千候选,采用多路召回(协同过滤、向量召回、热度召回等),借助Redis和向量数据库实现毫秒级响应。
- 排序:使用深度学习模型对候选进行精排,特征包括用户特征、物品特征、上下文特征和交叉特征,特征存储于Redis和HBase,支持实时读取。
- 重排:考虑多样性、新鲜度、商业规则等,进行打散和调整,最终返回推荐列表。
四、数据处理与存储支持服务
4.1 数据处理体系
百分点的数据处理体系涵盖数据采集、清洗、特征工程、模型训练和在线服务。
- 数据采集:通过SDK、日志收集器(Flume、Filebeat)将用户行为数据实时写入Kafka,同时批量导入数据湖。
- 数据清洗与整合:使用Spark SQL和Flink进行ETL,去除无效数据,补全缺失字段,生成用户画像和物品画像。
- 特征工程:分为批特征和流特征。批特征通过Hive/Spark计算,写入HBase或HDFS;流特征通过Flink计算,写入Redis。特征存储(Feature Store)统一管理特征元数据,确保线上线下一致性。
- 模型训练:基于Spark MLlib和TensorFlow/PyTorch进行分布式训练,样本存储于HDFS,训练完成后模型部署至预测服务。
- 在线服务:实时特征通过Redis读取,模型推理通过TensorFlow Serving或自研引擎完成,具备高吞吐低延迟能力。
4.2 存储支持服务
为应对亿级数据规模和多样化访问模式,百分点采用了混合存储架构:
- HDFS:存储全量历史数据、训练样本和离线特征,成本低、吞吐高。
- HBase:存储用户画像、物品画像等稀疏特征,支持随机读写和水平扩展。
- Redis:存储实时特征、热门物品列表和缓存推荐结果,提供亚毫秒级响应。
- Kafka:作为实时数据管道,缓冲用户行为日志和实时特征流,保证高吞吐与持久化。
- TiDB:存储元数据、配置信息和业务数据,具备分布式事务和强一致性。
- 向量数据库(Milvus) :存储物品和用户的嵌入向量,支持近似最近邻搜索,用于向量召回。
- 对象存储(如S3) :存储模型文件、备份数据和冷数据,成本低廉。
存储服务通过统一的数据访问层(DAL)进行封装,提供多租户、鉴权、监控和自动容灾能力,确保数据高可用和高可靠。
五、与展望
百分点亿级个性化推荐系统经过多年迭代,形成了从离线到实时、从单机到云原生的完整技术栈。数据处理与存储支持服务是推荐系统的基石,混合存储架构和分层数据处理体系有效支撑了亿级用户和物品的实时推荐。随着深度学习和向量检索技术的发展,推荐系统将更加智能化、实时化,存储与计算将进一步融合,向湖仓一体、实时数仓方向演进。百分点将持续探索,为各行业提供更精准、更高效的推荐服务。